Nota · ai-agents qualidade avaliacao testes
Construí um portão de qualidade para entregas de IA. Veja como especifiquei
Um passo a passo do portão de qualidade que especifiquei para entregas de IA, do ticket e diff até as verificações, o juiz, o placar e a calibração.
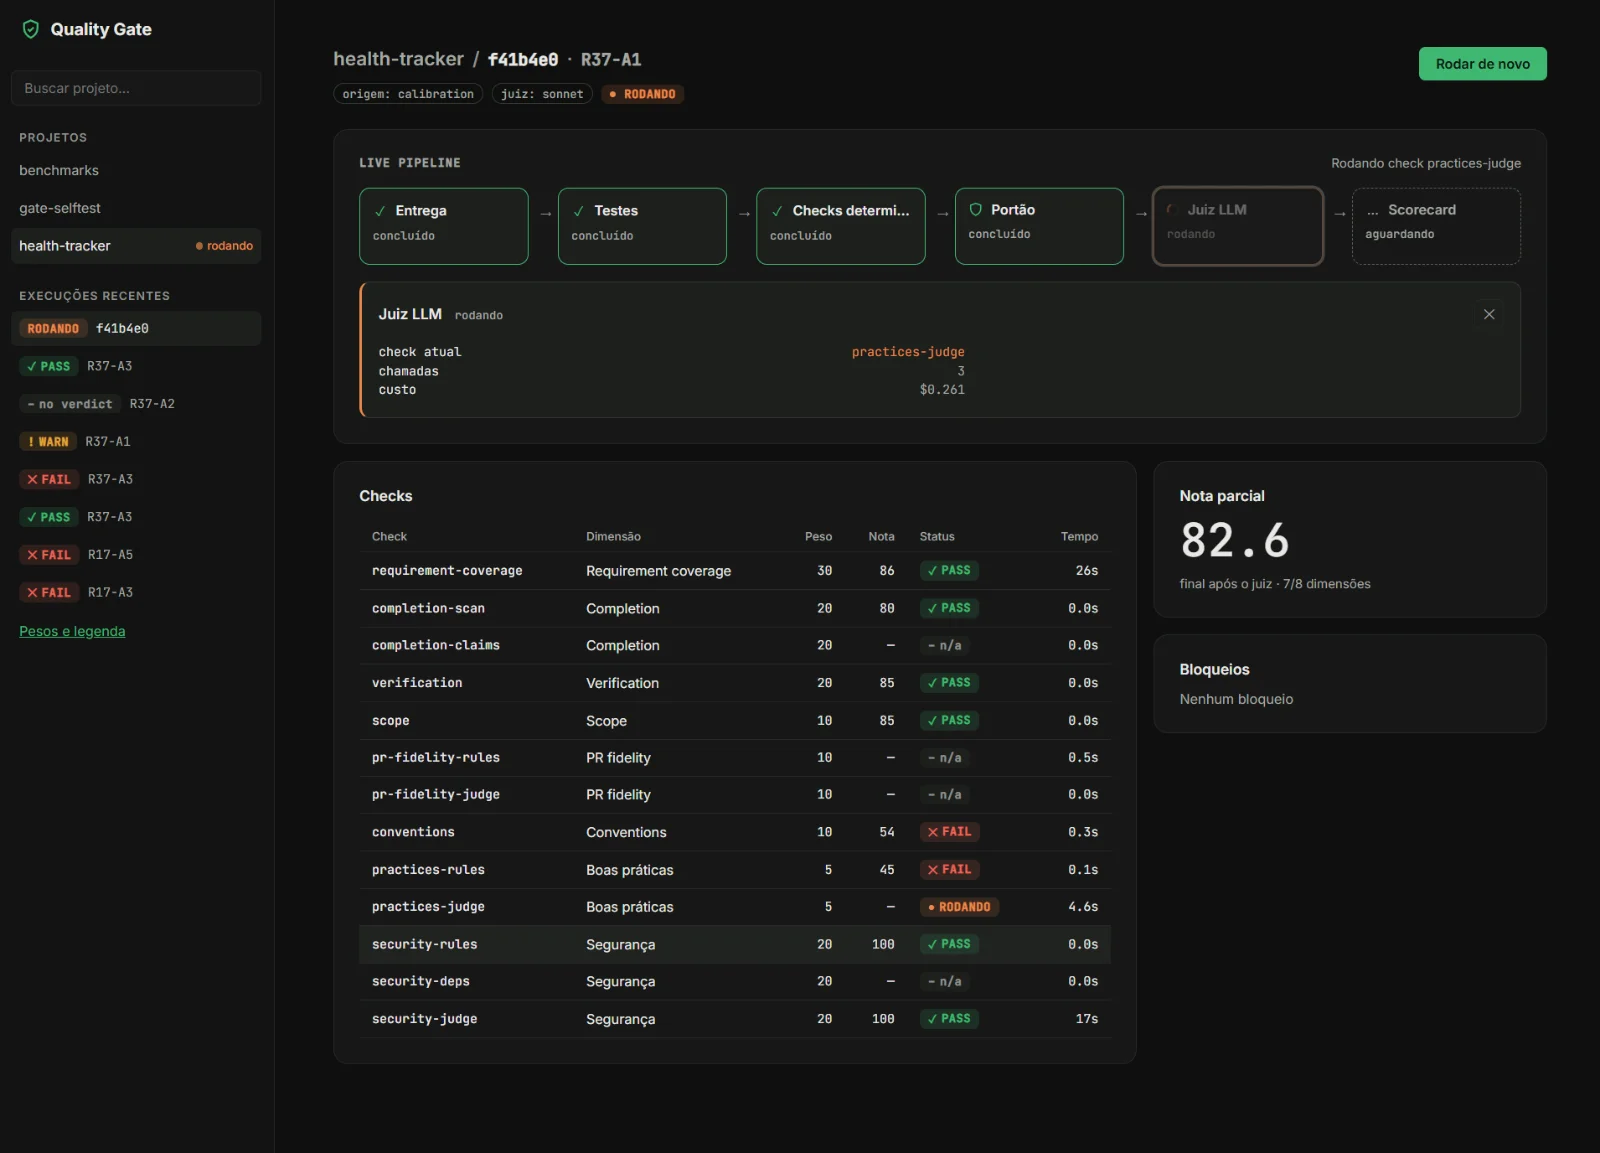
Tenho 69 itens entregues por IA para o meu aplicativo de acompanhamento de saúde no meu próprio histórico e, até este mês, nenhuma forma honesta de dizer quais foram bons. Eu tinha uma impressão. Impressões são o que você tem quando revisa a saída de IA no fim de um longo dia.
Venho pesquisando portões de qualidade e como posso confiar e avaliar entregas de IA com base nos meus próprios dados. Então, olhei para a pergunta que eu realmente tenho quando um agente termina uma tarefa. Preciso saber se esta entrega fez o que o ticket pediu, se terminou o trabalho, e se posso confiar na descrição do PR
O que eu achava que precisava
Comecei com uma skill chamada create-benchmark. A ideia era simples: rodar a mesma fatia do meu trabalho diário em diferentes modelos, pontuá-los e escolher o melhor. Um leaderboard para uso próprio.
Isso durou cerca de cinco fases até eu perceber o que eu realmente estava procurando. Então mudei o briefing: não preciso testar modelos e suas pontuações. Preciso de um benchmark que funcione como um portão de qualidade para o que a IA entrega nos meus projetos.
Um leaderboard pergunta qual modelo é melhor em média. Um portão pergunta se esta entrega, hoje, deve ser mesclada. E essa é a diferença entre eles. E a pergunta que o portão faz é a mesma que eu enfrento toda vez que um agente abre um PR.
O que o portão pergunta
Quatro perguntas, tiradas de como eu realmente reviso.
A IA entregou o que o ticket pediu? Foi até o fim, ou parou no primeiro sinal verde? Os resultados correspondem ao ticket? O título e a descrição do PR correspondem ao diff?
Cada pergunta se tornou uma dimensão ponderada. Então peguei emprestado o que o setor já mede, como taxas de resolução de issues, rastreabilidade de requisitos, cobertura em código novo, e boas práticas de mudanças pequenas, em vez de inventar as minhas próprias.
Hoje elas são: cobertura de requisitos, conclusão, verificação, segurança, escopo, fidelidade do PR, convenções e práticas gerais. A pontuação é uma média ponderada sobre as dimensões aplicáveis. 80 ou mais é um PASS, de 65 a 79 é um WARN, abaixo de 65 é um FAIL. Qualquer dimensão isolada abaixo de 40 reprova a entrega por si só, então uma dimensão forte não consegue esconder uma quebrada.
Além disso, há bloqueadores rígidos que reprovam independentemente da pontuação: um critério de aceitação marcado como ausente, um teste ou checagem de tipos falhando, um .only esquecido, um segredo nas linhas adicionadas, e a IA afirmando que os testes passaram quando a transcrição mostra que eles não rodaram.
Determinístico primeiro, juiz depois
Esta é a decisão que eu defenderia com mais convicção. Toda execução começa com o estágio determinístico: comandos de teste e checagem de tipos, escopo, convenções, varredura de conclusão, regras de PR, segredos. Se algo ali falhar ou levantar um bloqueador, o juiz LLM nunca roda.
Dois motivos. Um juiz custa dinheiro, e pontuar uma entrega que já falha em seus próprios testes é dinheiro desperdiçado. E a opinião de um juiz sobre um trabalho quebrado é ruído que torna o relatório mais difícil de ler. Quando o portão para cedo, as dimensões julgadas aparecem como puladas, e o veredito é FAIL com zero chamadas ao juiz.
Usando-o
Inicialmente fiz dele um comando de CLI, mas como eu mesmo não sou muito o tipo de dev que usa cli, fiz uma UI para ele e posso iniciar uma execução a partir dali. Isso é bom, mas não é bom o suficiente. Ele não agiria sobre o problema que o dispara: um agente abrindo um PR. E o que importa para mim é rodá-lo bem antes que esse PR seja criado.
Então criei um hook.
O hook roda antes de gh pr create, porque é nesse momento que quero pegar um PR enganoso ou uma entrega inacabada.
Dogfooding
Rodei o portão no seu próprio repositório. Ele encontrou coisas reais: funções com mais de 20 linhas, novos exports sem nenhum teste tocando neles, números mágicos, um bloco catch vazio.
Também encontrou falsos positivos em seus próprios analisadores. O detector de ReDoS sinalizou duas regexes no próprio código-fonte do portão como quantificadores aninhados e bloqueou a execução com dois achados de alta gravidade. O detector estava certo em suspeitar daquele formato e errado sobre aqueles padrões. Corrigi o detector.
Segurança entrou depois com peso 20, cobrindo IDOR, injeção de SQL, ReDoS, XSS, criptografia fraca e dependências vulneráveis, com achados críticos e altos bloqueando por conta própria. Práticas gerais entraram com peso 5 e são isentas do piso: elas devem apenas empurrar uma pontuação, nunca reprovar uma entrega sozinhas.
Resumindo
Agora, eu precisava de uma UI mais completa, então fiz um painel para listar projetos e execuções ativas. Abrir uma mostra a entrega passando por testes, verificações determinísticas, o portão, o juiz LLM, e o placar. A verificação atual e suas evidências aparecem conforme a execução progride.
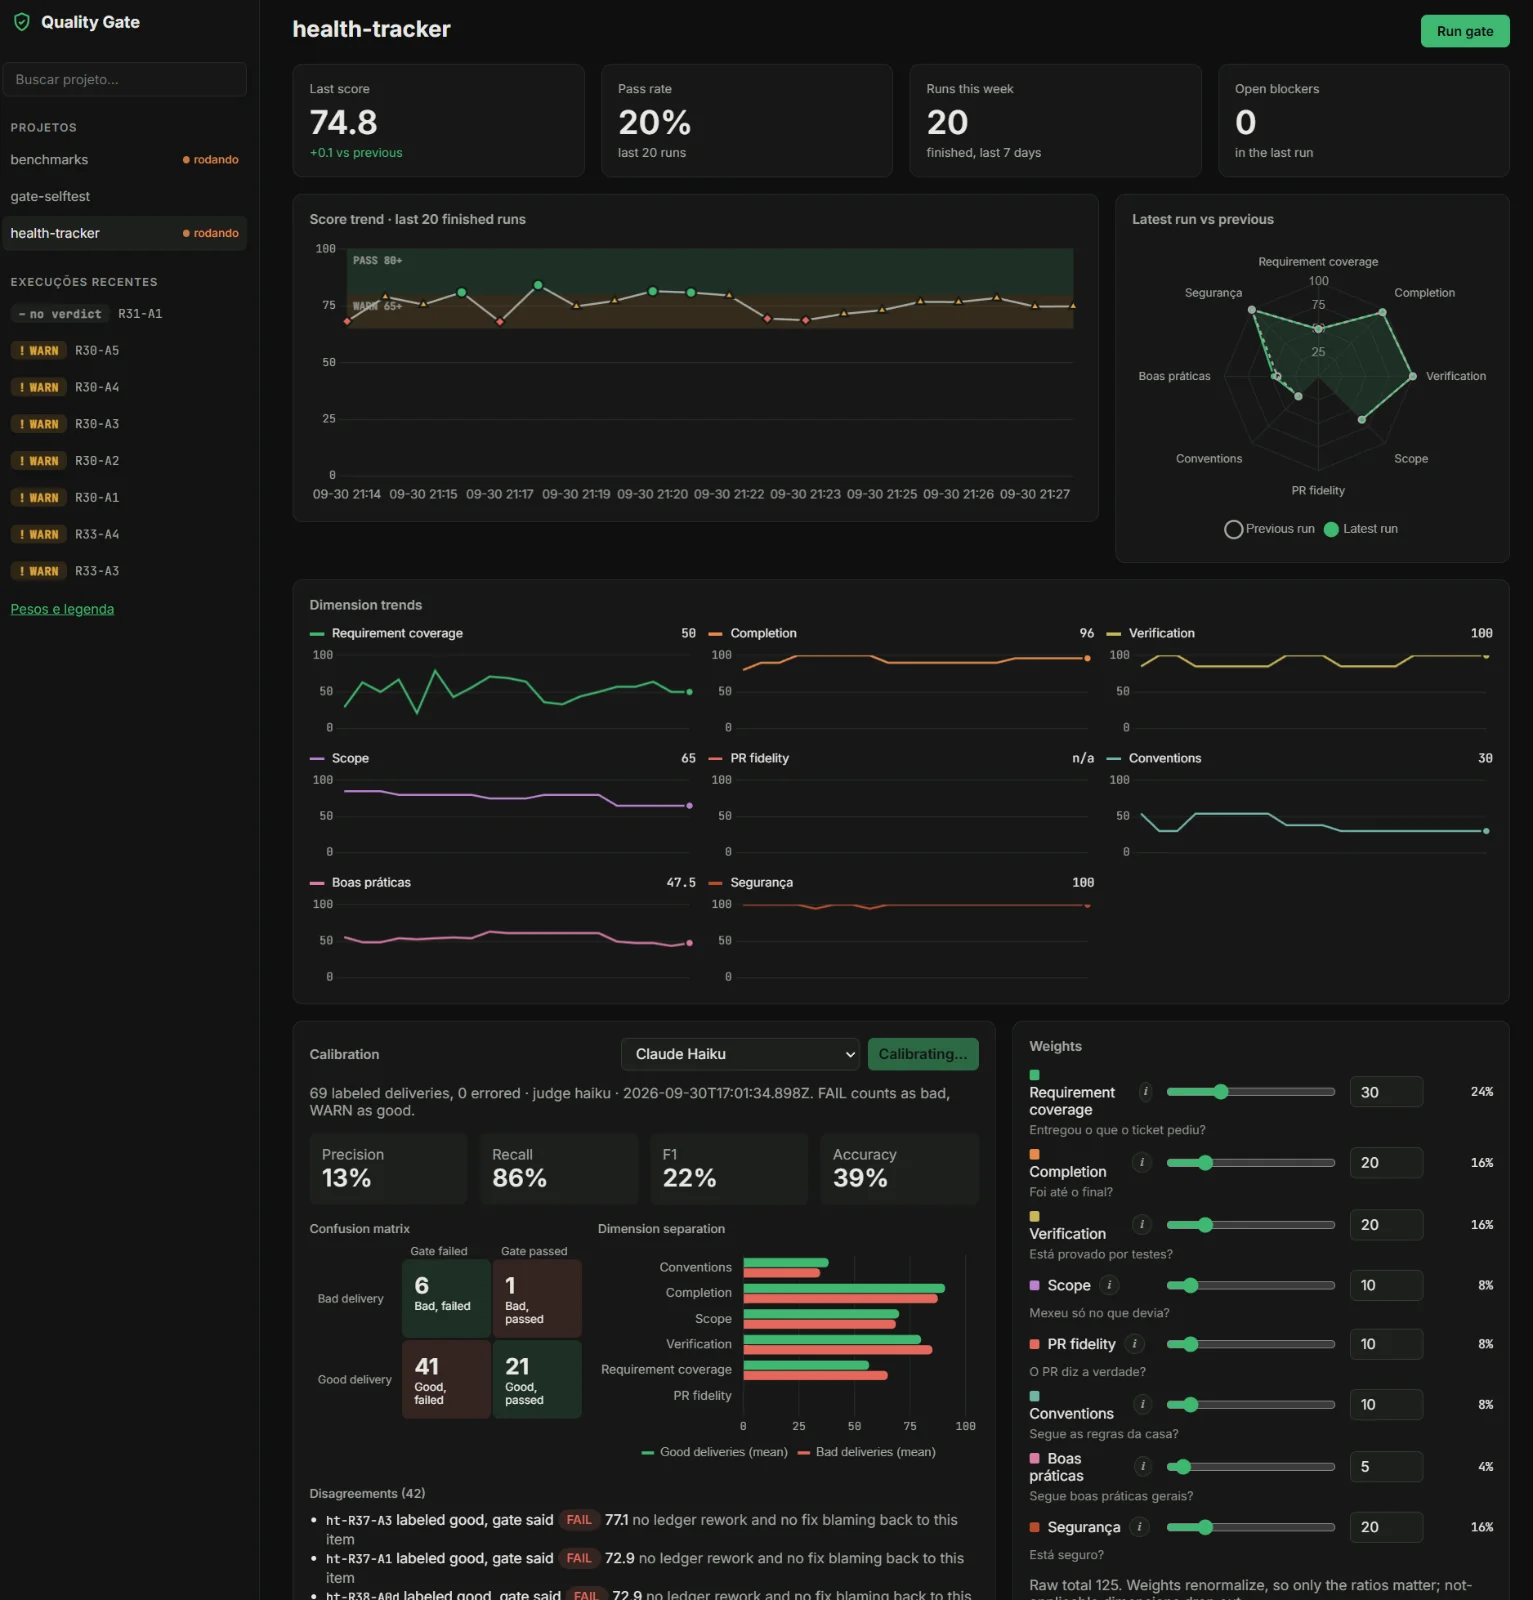
A UI me mostrou tudo o que eu queria: a verificação exata, a evidência e a regra por trás de um veredito, e então me deixou corrigir tanto a entrega quanto o portão. Às vezes a ferramenta encontra um problema real. Às vezes a sua própria regra está errada. Preciso conseguir distinguir qual é qual.
Essa ferramenta muito "simples" agora me ajuda a verificar se as minhas entregas de IA são boas, seguras e suficientemente completas.
Medir me fez passar de uma avaliação empírica para métricas realmente confiáveis (embora elas possam precisar de calibração)
Algo a acrescentar, ou uma parte de que você discorda? Me responda.
Responder por e-mail